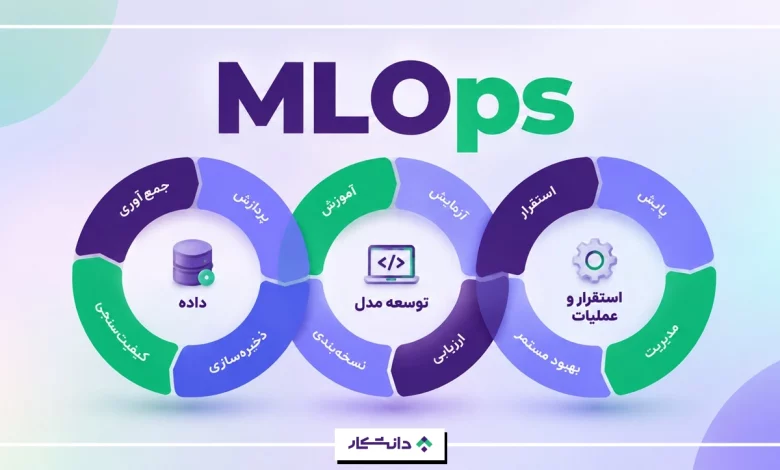
برای یکی از فروشگاههای بزرگ محلهمان قرار بود مدل هوش مصنوعی پیاده کنیم تا فروش بالاتری داشته باشد. اما بهمحض شروع فعالیت متوجه مشکلهایی مانند بررسی عملکرد مدل و… شدیم. برای برطرف کردن این دغدغهها از MLOps استفاده کردیم که کمک کرد فرایند منظم، قابل اعتماد و مقیاسپذیرتری داشته باشیم. برای آشنایی بیشتر با این مبحث در ادامه مطلب میخوانیم MLOps چیست، چگونه کار میکند و چرا یکی از مهمترین مهارتهای حوزه توسعه سیستمهای هوش مصنوعی است.
MLOps چیست؟
MLOps مجموعهای از روشها و فرایندهاست که با ترکیب یادگیری ماشین، مهندسی نرمافزار و DevOps، چرخه عمر کامل مدلهای یادگیری ماشین مانند مرحله توسعه و آموزش مدل گرفته تا استقرار و پایش آن در محیط عملیاتی را مدیریت میکند.
- یکپارچهسازی جریانهای کاری یادگیری ماشین با روشهای DevOps و مهندسی داده
- خودکارسازی فرایندهای آموزش مدل، استقرار، پایش و کنترل نسخهها
- بهبود همکاری تیمها، قابلیت بازتولید نتایج و حفظ عملکرد بلندمدت مدلها
چرا MLOps مهم است؟
فرض کنید مدلی برای پیشبینی قیمت خانه ساختهاید که روی سیستم شما عملکرد خوبی دارد. اما زمانی که میخواهید از این مدل در یک وبسایت استفاده کنید، چالشهای جدیدی ظاهر میشوند؛ مثل انتخاب نسخه مناسب مدل، مدیریت دادههای جدید، آموزش مجدد مدل بهصورت دورهای و بررسی عملکرد آن در محیط واقعی. در این شرایط میتوانید از MLOps استفاده کنید. MLOps با ایجاد هماهنگی، اعتمادپذیری و بهرهوری بیشتر، باعث بهبود فرایندهای توسعه و مدیریت مدلهای یادگیری ماشین میشود. کمکهای MLOps عبارتاند از:
- تمام مراحل کار بهصورت منظم مدیریت و نسخهبندی شوند.
- آموزش و آزمایش مدل بهراحتی تکرارپذیر باشد.
- مدل بدون پیچیدگیهای اضافی بهروزرسانی و در کاربردهای واقعی استفاده شود.
برای یادگیری دقیق این مبحث، دیدن آموزش MLOps دانشکار را به شما پیشنهاد میدهیم.
MLOps چگونه کار میکند؟
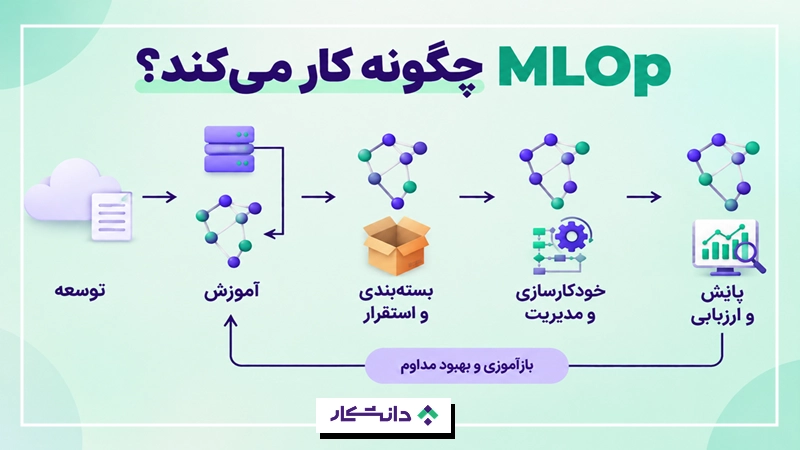
MLOps با ایجاد یک چرخه منظم، تمام مراحل توسعه، استقرار و نگهداری مدلهای یادگیری ماشین را مدیریت میکند. این چرخه از آمادهسازی دادهها شروع میشود و تا پایش عملکرد مدل و بهروزرسانی مداوم آن ادامه پیدا میکند. هدف اصلی MLOps این است که مدلهای یادگیری ماشین بتوانند به شکل قابل اعتماد، تکرارپذیر و مقیاسپذیر در محیط واقعی استفاده شوند.
جمعآوری و آمادهسازی دادهها
اولین مرحله در چرخه MLOps، آمادهسازی دادههایی است که مدل با استفاده از آنها آموزش میبیند. در این مرحله دادهها جمعآوری، پاکسازی و پردازش میشوند تا کیفیت مناسبی برای آموزش مدل داشته باشند. مدیریت صحیح دادهها اهمیت زیادی دارد؛ زیرا کیفیت دادهها تأثیر مستقیمی بر عملکرد مدل نهایی خواهد داشت.
توسعه و آموزش مدل یادگیری ماشین
پس از آمادهسازی دادهها، دانشمندان داده مدلهای مختلف را توسعه داده و آموزش میدهند. در این مرحله الگوریتمهای مختلف، پارامترهای مدل و روشهای پردازش داده بررسی میشوند تا بهترین مدل براساس معیارهای مشخص انتخاب شود.
نسخهبندی داده، کد و مدل
در پروژههای یادگیری ماشین، تنها کد برنامه نیاز به مدیریت نسخه ندارد؛ دادهها، تنظیمات آزمایشها و مدلهای آموزشدیده نیز باید نسخهبندی شوند. ابزارهایی مانند گیت، DVC و MLflow کمک میکنند تغییرات ثبت شوند، نتایج آزمایشها قابل پیگیری باشند و در صورت نیاز به نسخههای قبلی بازگردیم.
ردیابی آزمایشها
در طول توسعه مدل، آزمایشهای مختلفی با دادهها، الگوریتمها و تنظیمات متفاوت انجام میشود. ردیابی آزمایشها کمک میکند اطلاعاتی مانند پارامترهای مدل، دادههای استفادهشده، معیارهای ارزیابی و نتایج هر آزمایش ثبت شوند تا امکان مقایسه و انتخاب بهترین مدل فراهم شود.
یکپارچهسازی و استقرار مداوم (CI/CD)
در MLOps، فرآیندهایی مانند تست، اعتبارسنجی و استقرار مدل میتوانند به کمک Pipelineهای خودکار انجام شوند. CI/CD باعث میشود تغییرات جدید در کد، داده یا مدل قبل از ورود به محیط واقعی بررسی شوند و مدلها سریعتر و با خطای کمتر منتشر شوند.
استقرار مدل در محیط عملیاتی
پس از آمادهشدن مدل، باید آن را در اختیار کاربران یا سیستمهای دیگر قرار داد. این مرحله شامل انتقال مدل به محیط عملیاتی و فراهمکردن زیرساخت لازم برای اجرای آن است. مدلها میتوانند از طریق API، پردازش دستهای یا سرویسهای ابری در دسترس قرار بگیرند.
پایش و مدیریت عملکرد مدل
پس از استقرار، عملکرد مدل باید بهصورت مداوم بررسی شود. تغییر در دادههای ورودی، تغییر رفتار کاربران یا گذشت زمان ممکن است باعث کاهش دقت مدل شود. پایش معیارهایی مانند دقت، زمان پاسخگویی و تغییرات دادهها (Data Drift) کمک میکند مشکلات احتمالی سریعتر شناسایی شوند.
بازآموزی و بهروزرسانی مدل
مدلهای یادگیری ماشین برای حفظ عملکرد خود به دادههای جدید و بهبودهای مداوم نیاز دارند. براساس نتایج پایش و بازخوردهای دریافتشده، مدل میتواند دوباره آموزش داده شود، نسخه جدیدی از آن ایجاد شود و به محیط عملیاتی بازگردد. این چرخه باعث میشود مدل در طول زمان با تغییر شرایط سازگار باقی بماند.
اجزای اصلی معماری MLOps چیست؟
معماری MLOps چند بخش اصلی دارد که در کنار هم چرخه عمر مدلهای یادگیری ماشین را مدیریت میکنند. این اجزا کمک میکنند مدلها از مرحله آمادهسازی داده و توسعه تا استقرار، پایش و بهبود مداوم، به شکل منظم و قابل اعتماد مدیریت شوند.
مدیریت داده
دادهها پایه اصلی مدلهای یادگیری ماشین هستند و کیفیت آنها تأثیر مستقیمی بر عملکرد مدل دارد. مدیریت داده شامل جمعآوری، پاکسازی، ذخیرهسازی، پردازش و نسخهبندی دادههاست تا تیمها بتوانند از دادههای معتبر و قابل تکرار برای آموزش و ارزیابی مدل استفاده کنند.
مدیریت مدل
مدیریت مدل به کنترل چرخه عمر مدلهای یادگیری ماشین از مرحله توسعه و آزمایش تا استقرار و بهروزرسانی گفته میشود. این بخش شامل آموزش مدل، ارزیابی عملکرد، مقایسه نسخههای مختلف و مدیریت تغییرات مدلها است تا بهترین نسخه برای استفاده عملیاتی انتخاب شود.
رجیستری مدل
رجیستری مدل لوکال برای ثبت، ذخیره و مدیریت نسخههای مختلف مدلهای یادگیری ماشین است. در این بخش اطلاعاتی مانند نسخه مدل، معیارهای ارزیابی، تنظیمات آموزش و وضعیت مدل در چرخه توسعه، مانند آزمایش یا آماده استقرار، نگهداری میشود. ابزارهایی مانند MLflow Model Registry برای مدیریت این فرآیند استفاده میشوند.
سرویسدهی مدل
پس از آمادهشدن مدل، باید امکان استفاده از آن در محصولات و سیستمهای واقعی فراهم شود. سرویسدهی مدل شامل روشهای ارائه خروجی مدل از طریق API، پردازش دستهای (Batch Processing) یا سرویسهای ابری است و کمک میکند مدل با پایداری و مقیاس مناسب در محیط عملیاتی اجرا شود.
مشاهدهپذیری و تشخیص
پس از استقرار مدل، عملکرد آن باید بهصورت مداوم بررسی شود. مشاهدهپذیری شامل بررسی معیارهایی مانند دقت مدل، زمان پاسخگویی، مصرف منابع و تغییرات دادهها (Data Drift) است. این بخش کمک میکند مشکلات احتمالی مانند کاهش عملکرد مدل یا تغییر رفتار دادهها سریعتر شناسایی شده و برای اصلاح آنها اقدام شود.
اصول کلیدی MLOps چیست؟
MLOps برای مدیریت بهتر چرخه عمر مدلهای یادگیری ماشین، بر چند اصل کلیدی تمرکز دارد. این اصول کمک میکنند فرآیند توسعه، استقرار و نگهداری مدلها منظمتر، قابل اعتمادتر و قابل تکرار باشد.
- کنترل نسخه: در پروژههای یادگیری ماشین، علاوهبر کد، دادهها، تنظیمات آزمایشها و نسخههای مختلف مدل نیز باید مدیریت شوند. کنترل نسخه کمک میکند تغییرات ثبت شوند، نتایج آزمایشها قابل پیگیری باشند و تیمها بتوانند در صورت نیاز به نسخههای قبلی بازگردند.
- خودکارسازی فرآیندها: بسیاری از مراحل چرخه عمر مدل مانند آمادهسازی داده، آموزش، آزمایش و استقرار میتوانند زمانبر و مستعد خطا باشند. MLOps با خودکارسازی این فرآیندها، نیاز به انجام دستی کارهای تکراری را کاهش میدهد و سرعت توسعه مدلها را افزایش میدهد.
- یکپارچهسازی و استقرار مداوم: CI/CD با خودکارسازی تست، اعتبارسنجی و انتشار تغییرات، کمک میکند مدلهای یادگیری ماشین سریعتر و با اطمینان بیشتری وارد محیط عملیاتی شوند. این فرآیند باعث میشود تغییرات جدید قبل از استفاده واقعی بررسی شوند و کیفیت مدل حفظ شود.
- حاکمیت مدل: حاکمیت مدل به مجموعهای از فرآیندها برای مدیریت، نظارت و کنترل مدلهای یادگیری ماشین در طول چرخه عمر آنها گفته میشود. این اصل شامل ثبت تغییرات، بررسی عملکرد مدل، مدیریت دسترسیها و اطمینان از رعایت استانداردهای امنیتی و قانونی است.
تفاوت MLOps و DevOps چیست؟
در جدول زیر، تفاوتهای اصلی MLOps و دواپس را بررسی کردهایم:
| ویژگی | MLOps | DevOps |
|---|---|---|
| تمرکز اصلی | پروژههای یادگیری ماشین | پروژههای توسعه نرمافزار |
| نسخهبندی | علاوهبر کد، دادهها، مدلها و آزمایشها را نیز مدیریت و نسخهبندی میکند. | بیشتر روی نسخهبندی کد تمرکز دارد و شامل داده و مدل نمیشود. |
| اجزای اصلی | مدلهای یادگیری ماشین، Pipelineهای داده و جریانهای کاری مهندسی ویژگی | کد منبع، فایلهای اجرایی، فایلهای پیکربندی و زیرساخت بهعنوان کد |
| پایش و نظارت | عملکرد مدل، تغییرات دادهها، تغییر مفهوم دادهها و معیارهای اختصاصی یادگیری ماشین را بررسی میکند. | عملکرد نرمافزار، معیارهای سیستم و تجربه کاربر را با استفاده از معیارهای سنتی فناوری اطلاعات بررسی میکند. |
| ابزارها | فریمورکهای یادگیری ماشین، ابزارهای CI/CD و پلتفرمهای مدیریت و هماهنگسازی | ابزارهای CI/CD و Orchestration مانند Jenkins، GitLab CI/CD و Kubernetes |
| تیمها | تیمهای چندتخصصی شامل دانشمندان داده، مهندسان یادگیری ماشین، مهندسان داده و متخصصان دواپس | توسعهدهندگان نرمافزار، تیم عملیات IT، تیم کنترل کیفیت (QA) و سایر اعضای مرتبط با توسعه نرمافزار |
| دفعات بهروزرسانی | مدلها براساس دادههای جدید و بازخوردها بهصورت مداوم آموزش مجدد داده شده و بهروزرسانی میشوند. | نرمافزارها براساس چرخه انتشار نسخهها یا اضافهشدن قابلیتهای جدید بهروزرسانی میشوند. |
مزایای MLOps چیست؟
مدلهای یادگیری ماشین با شناسایی الگوها در دادهها، پیشبینی انجام میدهند. اما با گذشت زمان و ورود دادههای جدیدی که مدل در زمان آموزش با آنها مواجه نبوده است، مشکلی به نام Data Drift یا تغییر توزیع دادهها ایجاد میشود. این تغییرات میتوانند باعث کاهش دقت مدل و تأثیر منفی روی عملکرد کسبوکار شوند. MLOps با ایجاد فرآیندهای منظم برای مدیریت، پایش و بهروزرسانی مدلها کمک میکند عملکرد آنها در طول زمان حفظ شود.
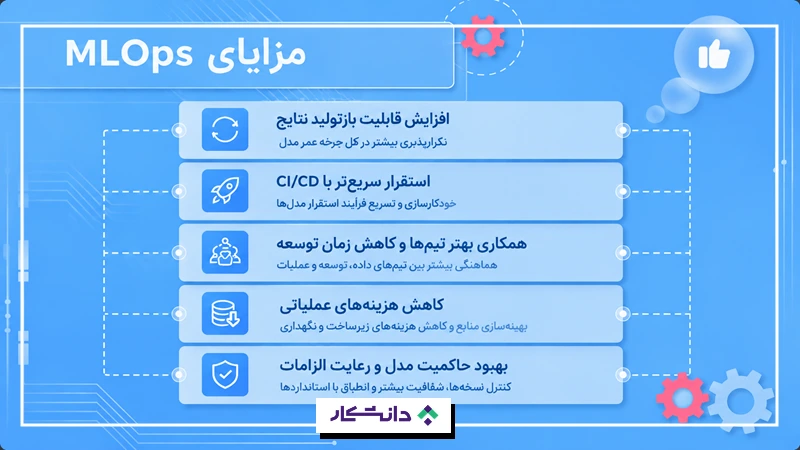
- افزایش قابلیت بازتولید نتایج: MLOps کمک میکند آزمایشهای یادگیری ماشین بهصورت قابل تکرار انجام شوند. با ثبت و مدیریت تغییرات مربوط به کد، دادهها و تنظیمات مدل، تیمها میتوانند نسخههای مختلف مدل را بررسی کنند و در صورت نیاز به نتایج قبلی بازگردند.
- استقرار سریعتر با CI/CD: چارچوبهای MLOps با Pipelineهای یکپارچهسازی و استقرار مداوم (CI/CD) ترکیب میشوند و فرآیندهایی مانند تست، اعتبارسنجی و انتشار مدل را خودکار میکنند. این موضوع باعث میشود مدلها سریعتر و با خطای کمتر وارد محیط عملیاتی شوند.
- همکاری بهتر تیمها و کاهش زمان توسعه: MLOps با ایجاد یک فرآیند مشترک بین دانشمندان داده، مهندسان یادگیری ماشین و تیمهای فنی، موانع همکاری را کاهش میدهد. همچنین با خودکارسازی فعالیتهای تکراری، تیمها میتوانند مدلهای بیشتری را سریعتر توسعه، آزمایش و بهبود دهند.
- کاهش هزینههای عملیاتی: نگهداری و بهبود مداوم مدلهای یادگیری ماشین، بهخصوص زمانی که بهصورت دستی انجام شود، زمانبر و پرهزینه است. MLOps با خودکارسازی فرآیندها، نیاز به فعالیتهای دستی را کاهش میدهد، احتمال خطا را کمتر میکند و استفاده از منابع را بهینهتر میسازد.
- بهبود حاکمیت مدل و رعایت الزامات: MLOps به سازمانها کمک میکند اقدامات امنیتی، کنترل دسترسی و الزامات مربوط به حریم خصوصی دادهها را بهتر مدیریت کنند. همچنین با پایش مداوم عملکرد مدل، تغییرات ایجادشده در دادهها و کاهش دقت مدل سریعتر شناسایی میشوند و امکان اصلاح بهموقع فراهم میشود.
چالشها و محدودیتهای MLOps چیست؟
MLOps یا عملیات یادگیری ماشین، رویکردی است که با ترکیب مفاهیم یادگیری ماشین، مهندسی نرمافزار و دواپس، به سازمانها کمک میکند مدلهای هوش مصنوعی را از مرحله توسعه و آموزش تا استقرار، پایش و مدیریت در محیط واقعی به شکل بهتری کنترل کنند. با افزایش استفاده از مدلهای یادگیری ماشین در کسبوکارها، چالشهایی مانند انتقال مدل به محصول، حفظ دقت آن در طول زمان و مدیریت نسخههای مختلف مدل اهمیت بیشتری پیدا کردهاند؛ چالشهایی که MLOps برای حل آنها شکل گرفته است. در ادامه به چالشهای مربوط به MLOps هم اشاره کردهایم:
- استقرار و یکپارچهسازی مدل
- پایش و نگهداری مدل
- مدیریت و حاکمیت دادهها
- مقیاسپذیری و مدیریت منابع
- همکاری و ارتباط بین تیمها
- امنیت و حریم خصوصی
ابزارها و فریمورکهای محبوب MLOps
پیادهسازی MLOps به مجموعهای از ابزارها نیاز دارد که بخشهای مختلف چرخه عمر مدل، از مدیریت داده و آزمایشها تا استقرار و پایش را پوشش دهند. هر ابزار برای حل یک بخش مشخص از فرآیند MLOps استفاده میشود و سازمانها براساس نیاز، زیرساخت و معماری خود ترکیبی از آنها را انتخاب میکنند.
MLflow برای مدیریت آزمایشها و مدلها
MLflow یکی از محبوبترین ابزارهای متنباز در MLOps است که برای ثبت و مدیریت آزمایشهای یادگیری ماشین، پیگیری پارامترهای مدل، ذخیره معیارهای ارزیابی و مدیریت نسخههای مختلف مدل استفاده میشود. این ابزار کمک میکند تیمها بتوانند آزمایشهای مختلف را مقایسه کنند و فرآیند انتقال مدل از توسعه به محیط عملیاتی را بهتر مدیریت کنند.
DVC برای نسخهبندی دادهها
در پروژههای یادگیری ماشین، فقط کد نیاز به نسخهبندی ندارد؛ دادهها و مدلها نیز باید قابل مدیریت باشند. DVC با اتصال به سیستمهای کنترل نسخه مانند گیت، امکان ثبت تغییرات دادهها، مدیریت نسخههای مختلف دیتاست و بازگشت به نسخههای قبلی را فراهم میکند.
ایجاد محیطهای قابل تکرار با داکر
داکر با بستهبندی کد، کتابخانهها و وابستگیهای موردنیاز در قالب کانتینر، کمک میکند مدلهای یادگیری ماشین در محیطهای مختلف با رفتار مشابه اجرا شوند. این موضوع باعث کاهش مشکلات مربوط به تفاوت محیط توسعه و محیط عملیاتی میشود.
مدیریت و مقیاسدهی استقرار مدلها با Kubernetes
Kubernetes برای مدیریت کانتینرها و اجرای سرویسهای مقیاسپذیر استفاده میشود. در پروژههای MLOps، این ابزار کمک میکند مدلهای یادگیری ماشین به شکل پایدار در محیط عملیاتی اجرا شوند و منابع موردنیاز آنها مدیریت شود.
ابزارهای CI/CD در پروژههای MLOps
ابزارهای CI/CD باعث میشوند تغییرات کد، داده یا مدل بهصورت خودکار آزمایش، اعتبارسنجی و در صورت تأیید منتشر شوند. این فرآیند سرعت توسعه را افزایش میدهد و خطاهای انسانی را کاهش میدهد.
بهترین روشهای پیادهسازی MLOps چیست؟
پیادهسازی موفق MLOps فقط به انتخاب ابزارهای مناسب محدود نمیشود؛ بلکه نیازمند ایجاد فرآیندهایی استاندارد برای مدیریت داده، توسعه مدل، استقرار و پایش مداوم آن است. هدف اصلی این روشها، ایجاد یک چرخه قابل اعتماد است که در آن مدلهای یادگیری ماشین بتوانند سریعتر توسعه پیدا کنند، بهراحتی بهروزرسانی شوند و عملکرد خود را در محیط واقعی حفظ کنند.
- استانداردسازی فرآیند توسعه مدل: برای اینکه توسعه مدلهای یادگیری ماشین قابل تکرار و مدیریت باشد، باید مراحل مختلف مانند آمادهسازی داده، آموزش، آزمایش و استقرار مدل به شکل مشخص و استاندارد انجام شوند. این کار باعث میشود اعضای تیم بتوانند با فرآیندهای یکسان کار کنند و نتایج قابل اعتمادتری به دست آورند.
- استفاده از کنترل نسخه برای داده و مدل: در پروژههای یادگیری ماشین فقط کد نیاز به نسخهبندی ندارد؛ دادهها، تنظیمات آزمایشها و مدلهای آموزشدیده نیز باید مدیریت شوند. ابزارهایی مانند گیت، DVC و MLflow کمک میکنند تغییرات ثبت شوند و امکان بررسی یا بازگشت به نسخههای قبلی فراهم باشد.
- ایجاد Pipelineهای خودکار: Pipelineهای خودکار، مراحل تکراری مانند دریافت و آمادهسازی داده، آموزش مدل، آزمایش، ارزیابی و استقرار را بدون دخالت دستی اجرا میکنند. این کار باعث کاهش خطاهای انسانی، افزایش سرعت توسعه و سادهتر شدن مدیریت چرخه عمر مدل میشود.
- پایش مداوم عملکرد مدل: پس از استقرار مدل، عملکرد آن باید بهصورت مداوم بررسی شود تا مشکلاتی مانند کاهش دقت، تغییر رفتار دادهها (Data Drift) یا افت کیفیت پیشبینیها سریعتر شناسایی شوند. پایش مداوم کمک میکند مدل در طول زمان همچنان عملکرد مناسبی داشته باشد.
- ایجاد چرخه بازخورد برای بهبود مدل: مدلهای یادگیری ماشین با تغییر دادهها و شرایط کسبوکار ممکن است نیاز به بهروزرسانی داشته باشند. ایجاد یک چرخه بازخورد از دادههای جدید، عملکرد مدل و نیازهای کاربران کمک میکند مدلها بهصورت مداوم بهبود پیدا کنند و با شرایط جدید سازگار شوند.
سطوح بلوغ MLOps
برای پیادهسازی مؤثر MLOps، سازمانها در سه سطح مختلف از خودکارسازی پیشرفت میکنند. هر سطح، میزان بلوغ فرآیندهای توسعه، استقرار و مدیریت مدلهای یادگیری ماشین را نشان میدهد. با افزایش سطح بلوغ، فرآیندها از حالت دستی به سمت خودکار، مقیاسپذیر و قابل اعتماد حرکت میکنند.
سطح صفر: بدون MLOps
در این سطح، بیشتر مراحل توسعه و استقرار مدل بهصورت دستی انجام میشود. دانشمندان داده مدلها را آموزش میدهند، نتایج را بررسی میکنند و در صورت نیاز مدل را به محیط عملیاتی منتقل میکنند. این روش معمولاً باعث ایجاد مشکلاتی در تکرارپذیری، همکاری تیمی و مدیریت نسخههای مختلف مدل میشود.
سطح یک: خودکارسازی Pipelineهای یادگیری ماشین
در این مرحله، برخی از فرآیندهای تکراری مانند آمادهسازی داده، آموزش مدل و ارزیابی آن خودکار میشوند. ایجاد Pipelineهای یادگیری ماشین باعث میشود مراحل توسعه مدل قابل تکرار باشند و تیمها بتوانند مدلها را سریعتر آزمایش و بهبود دهند.
سطح دو: CI/CD و استقرار خودکار مدل
در بالاترین سطح بلوغ، علاوهبر Pipelineهای یادگیری ماشین، فرآیندهای یکپارچهسازی و استقرار مداوم نیز خودکار میشوند. در این سطح، تغییرات کد، داده یا مدل بهصورت خودکار آزمایش، اعتبارسنجی و در محیط عملیاتی منتشر میشوند. همچنین پایش مداوم مدل و بازآموزی آن در صورت نیاز، بخشی از چرخه مدیریت مدل خواهد بود.
MLOps در محیط ابری و On-Premise چیست؟
مدلهای یادگیری ماشین برای اجرا در محیط واقعی به زیرساخت مناسب نیاز دارند. سازمانها میتوانند زیرساخت MLOps خود را در محیطهای ابری (Cloud)، زیرساخت داخلی سازمان (On-Premise) یا ترکیبی از هر دو پیادهسازی کنند. انتخاب بین این روشها به عواملی مانند حجم داده، نیازهای امنیتی، هزینهها و میزان کنترل موردنیاز سازمان بستگی دارد.
MLOps در Cloud
در مدل Cloud، زیرساختهای موردنیاز برای توسعه، آموزش، استقرار و پایش مدلها روی سرویسهای ابری ارائهدهندگانی مانند AWS، Google Cloud و Microsoft Azure قرار میگیرند. این روش به سازمانها اجازه میدهد بدون نیاز به خرید و نگهداری سختافزار اختصاصی، منابع محاسباتی موردنیاز خود را براساس نیاز افزایش یا کاهش دهند.
از مزایای MLOps ابری میتوان به مقیاسپذیری سریع، دسترسی به ابزارهای آماده، کاهش هزینههای نگهداری زیرساخت و سادهتر شدن مدیریت چرخه عمر مدل اشاره کرد. سرویسهایی مانند Amazon SageMaker، Google Vertex AI و Azure Machine Learning امکاناتی برای آموزش، استقرار و پایش مدلهای یادگیری ماشین ارائه میدهند.
MLOps در محیط On-Premise
در رویکرد On-Premise، سازمان زیرساخت سختافزاری و نرمافزاری MLOps را در دیتاسنتر داخلی خود مدیریت میکند. در این مدل، دادهها و مدلها داخل زیرساخت سازمان باقی میمانند و تیم فنی کنترل بیشتری روی امنیت، دسترسیها و تنظیمات سیستم دارد.
این روش برای سازمانهایی مناسب است که به دلیل حساسیت دادهها، الزامات امنیتی یا قوانین داخلی، امکان استفاده کامل از سرویسهای ابری را ندارند. البته مدیریت زیرساخت، تأمین منابع پردازشی و نگهداری تجهیزات در این مدل نیازمند هزینه و تخصص فنی بیشتری است.
تفاوت Cloud و On-Premise در MLOps
برای درک بهتر محیطهای مناسب MLOps تفاوتهای آنها را در قالب جدول نوشتهایم.
| ویژگی | MLOps در Cloud | MLOps در On-Premise |
|---|---|---|
| زیرساخت | توسط ارائهدهنده ابری مدیریت میشود. | توسط خود سازمان مدیریت میشود. |
| مقیاسپذیری | افزایش و کاهش منابع سریعتر انجام میشود | نیازمند تهیه و تنظیم سختافزار جدید است |
| کنترل روی دادهها | کنترل کمتر نسبت به زیرساخت داخلی | کنترل کاملتر روی دادهها و دسترسیها |
| هزینه اولیه | کمتر، به خرید تجهیزات نیاز ندارد. | بیشتر، هزینه سختافزار و نگهداری دارد. |
| امنیت و انطباق | وابسته به تنظیمات سرویسدهنده و قراردادها | امکان کنترل دقیقتر براساس سیاستهای سازمان |
| مدیریت و نگهداری | بخشی از مسئولیت برعهده ارائهدهنده ابری است | تمام مسئولیت مدیریت برعهده سازمان است |
آینده MLOps و ارتباط آن با LLMOps
با گسترش استفاده از مدلهای پیچیدهتر هوش مصنوعی، مدیریت چرخه عمر این مدلها نیز به چالش بزرگتری تبدیل شده است. آینده MLOps به سمت خودکارسازی بیشتر، مدیریت مدلهای بزرگتر و ایجاد فرآیندهای دقیقتر برای توسعه، استقرار و پایش مدلها حرکت میکند. با ظهور مدلهای زبانی بزرگ (LLMها) و هوش مصنوعی مولد، علاوهبر مدیریت مدل، مواردی مانند نسخهبندی Promptها، ارزیابی کیفیت پاسخها، کنترل هزینه پردازش و پایش رفتار مدل نیز اهمیت بیشتری پیدا کردهاند.
به همین دلیل، مفهوم LLMOps بهعنوان توسعهای از MLOps برای مدیریت مدلهای زبانی بزرگ شکل گرفته است. درحالیکه MLOps بیشتر روی چرخه عمر مدلهای سنتی یادگیری ماشین تمرکز دارد، LLMOps چالشهای خاص مدلهای مولد مانند مدیریت پرامپت، تشخیص خطاهایی مانند تولید اطلاعات نادرست (Hallucination) و ارزیابی خروجیهای متنی را نیز پوشش میدهد. به بیان ساده، MLOps پایه مدیریت مدلهای هوش مصنوعی را فراهم میکند و LLMOps این فرآیند را برای نسل جدید سیستمهای مبتنیبر مدلهای زبانی بزرگ گسترش میدهد.
منابع: ibm.com، redhat.com