هر بار که قفل تلفن همراهم با تشخیص چهره باز میشود، یک فروشگاه اینترنتی محصولی متناسب با علاقهام پیشنهاد میدهد یا از یک مدل هوش مصنوعی سؤالی میپرسم و در چند ثانیه جواب میگیرم، در واقع دارم نتیجه کار شبکههای عصبی را تجربه میکنم. شبکههای عصبی پشت بسیاری از فناوریهایی هستند که امروز از آنها استفاده میکنم؛ از پردازش تصویر و تشخیص گفتار گرفته تا پردازش زبان طبیعی، پزشکی، خودروهای خودران و هوش مصنوعی مولد. اما همیشه برایم سؤال بوده که شبکه عصبی دقیقاً چیست و چطور از دادهها یاد میگیرد؟ در این مطلب از مجله دانشکار، شبکههای عصبی در یادگیری عمیق را بررسی کردهام تا ببینیم چگونه کار میکنند.
شبکه عصبی چیست؟
شبکه عصبی مصنوعی یا Artificial Neural Network مدلی در یادگیری ماشین است که از تعدادی نورون مصنوعیِ بههممتصل تشکیل میشود. هر نورون چند مقدار را دریافت میکند، اهمیت هر ورودی را با یک وزن میسنجد، مجموع آنها را محاسبه میکند و نتیجه را پس از عبور از یک تابع فعالسازی به نورونهای بعدی میفرستد.
نام این مدل از شبکه نورونهای زیستی الهام گرفته شده است، اما شبکه عصبی کامپیوتری کپی دقیق مغز انسان نیست. نورون مصنوعی در اصل یک تابع ریاضی نسبتاً ساده است و توانایی شبکه از همکاری تعداد زیادی از این توابع، معماری مناسب و آموزش با داده به وجود میآید.
برای مثال، فرض کنید میخواهیم قیمت یک خانه را پیشبینی کنیم. متراژ، سن بنا، محله و تعداد اتاقها ورودی شبکه هستند. مدل در طول آموزش یاد میگیرد هر ویژگی چه اثری بر قیمت دارد. اگر موقعیت مکانی در دادههای آموزشی عامل مهمتری باشد، شبکه وزن بیشتری برای آن در نظر میگیرد. خروجی نهایی میتواند قیمت تخمینی خانه باشد.
تعریف سادهای از نورون مصنوعی
کار نورون را میتوان با رابطه زیر نمایش داد:
خروجی = تابع فعالسازی(مجموعِ ورودی × وزن + بایاس)
اگر ورودیها را با x، وزنها را با w و بایاس را با b نشان دهیم، شکل خلاصه رابطه بهصورت زیر است:
y = f(Σwᵢxᵢ + b)
- ورودیها اطلاعاتی هستند که نورون دریافت میکند.
- وزنها اهمیت نسبی ورودیها را نشان میدهند.
- بایاس به مدل اجازه میدهد مرز تصمیم خود را انعطافپذیرتر جابهجا کند.
- تابع فعالسازی رابطهای غیرخطی ایجاد میکند تا شبکه فقط به یادگیری الگوهای ساده و خطی محدود نباشد.
رابطه هوش مصنوعی، یادگیری ماشین، یادگیری عمیق و شبکه عصبی
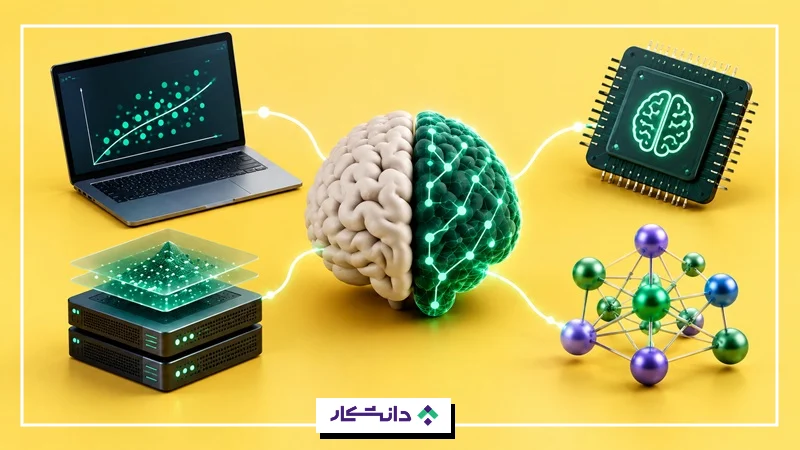
هوش مصنوعی، یادگیری ماشین، یادگیری عمیق و شبکههای عصبی مفاهیم جدا از هم نیستند، بلکه بخشی از یک ساختار سلسلهمراتبیاند. هوش مصنوعی مفهوم گستردهتری است، یادگیری ماشین یکی از زیرشاخههای آن محسوب میشود، یادگیری عمیق زیرمجموعه یادگیری ماشین است و شبکههای عصبی، پایه اصلی بسیاری از روشهای یادگیری عمیق را تشکیل میدهند.
- هوش مصنوعی (AI) حوزه گسترده ساخت سیستمهایی است که رفتار هوشمندانه نشان میدهند.
- یادگیری ماشین (ML) زیرمجموعهای از هوش مصنوعی است که مدل را قادر میسازد از داده الگو بیاموزد.
- شبکه عصبی یکی از خانوادههای مدلهای یادگیری ماشین است.
- یادگیری عمیق (DL) بخشی از یادگیری ماشین است که عمدتاً از شبکههای عصبی با چندین لایه محاسباتی استفاده میکند.
بنابراین، هر شبکه عصبی لزوماً عمیق نیست. یک پرسپترون یا شبکه کمعمق نیز شبکه عصبی محسوب میشود اما در یک شبکه عصبی عمیق، داده از لایههای بیشتری عبور میکند و هر لایه میتواند بازنمایی پیچیدهتری از داده بسازد.
تفاوت یادگیری ماشین و یادگیری عمیق
یادگیری ماشین و یادگیری عمیق هر دو به سیستمها کمک میکنند از دادهها یاد بگیرند، اما روش یادگیری و میزان دخالت انسان در آنها متفاوت است. یادگیری عمیق در واقع زیرمجموعهای از یادگیری ماشین است که با استفاده از شبکههای عصبی چندلایه، میتواند الگوهای پیچیدهتری را از حجم بالای داده استخراج کند. در جدول زیر، مهمترین تفاوتهای یادگیری ماشین و یادگیری عمیق را مقایسه میکنیم.
| معیار | یادگیری ماشین | یادگیری عمیق |
|---|---|---|
| استخراج ویژگی | اغلب به طراحی و انتخاب ویژگی توسط متخصص نیاز دارد | بسیاری از ویژگیها را خودکار و مرحلهبهمرحله یاد میگیرد |
| نوع داده مناسب | دادههای جدولی و ساختاریافته | تصویر، متن، صوت، ویدئو و دادههای پیچیده |
| حجم داده | میتواند با داده کمتر هم نتیجه خوبی بدهد | معمولاً از داده بیشتر سود میبرد |
| توان محاسباتی | اغلب کمتر | معمولاً بیشتر و گاهی نیازمند GPU یا شتابدهنده |
| زمان آموزش | کوتاهتر | ممکن است طولانیتر باشد |
| تفسیرپذیری | در بسیاری از مدلها سادهتر | اغلب دشوارتر و شبیه جعبه سیاه |
| مهندسی ویژگی | نقش پررنگتر انسان | یادگیری بازنمایی تا حد زیادی خودکار است |
| مسائل پیچیده | عالی برای بسیاری از مسائل ساده و متوسط | در الگوهای غیرخطی و دادههای بدون ساختار قدرتمند است |
چرا شبکههای عصبی برای یادگیری عمیق مهم هستند؟
مزیت اصلی شبکه عصبی، توانایی یادگیری بازنمایی سلسلهمراتبی است. در یک سامانه تشخیص تصویر، لایههای ابتدایی ممکن است لبهها و رنگها را تشخیص دهند؛ لایههای میانی شکلها و بافتها را ترکیب کنند؛ و لایههای عمیقتر مفهومهایی مانند چشم، چرخ یا چهره را تشخیص دهند. برنامهنویس لازم نیست تمام این ویژگیها را یکییکی تعریف کند.
همین منطق در متن و صوت نیز دیده میشود. مدل میتواند از حروف و واژهها به عبارت، بافت و معنای جمله برسد یا از موج صوتی، ویژگیهای آوایی و سپس کلمه را استخراج کند. این توانایی باعث شده است شبکههای عصبی در مسائلی که مرز تصمیم پیچیده و غیرخطی دارند، بسیار مؤثر باشند. مهمترین دلایل استفاده از یادگیری عمیق عبارتاند از:
- کاهش نیاز به مهندسی دستی ویژگی: مدل بسیاری از ویژگیهای مفید را مستقیماً از داده خام یاد میگیرد.
- مدلسازی روابط پیچیده: ترکیب لایهها و توابع غیرخطی به شبکه اجازه میدهد الگوهایی را یاد بگیرد که با مدلهای ساده قابل بیان نیستند.
با دیدن ویدیوهای آموزش یادگیری عمیق، مفاهیم مربوط به شبکههای عصبی را دقیقتر یاد بگیرید.
اجزای اصلی شبکه عصبی
برای اینکه بفهمیم یک شبکه عصبی چگونه اطلاعات را پردازش میکند و از دادهها یاد میگیرد، ابتدا باید با بخشهای اصلی آن آشنا شویم. هر شبکه عصبی از چند جزء تشکیل شده که هرکدام نقش مشخصی در دریافت داده، پردازش آن و تولید نتیجه دارند. در ادامه، مهمترین اجزای یک شبکه عصبی را بررسی میکنیم.
- لایه ورودی: لایه ورودی داده را دریافت میکند. در یک مدل قیمت خانه، هر ویژگی مانند متراژ یا سن بنا میتواند یک ورودی باشد. در تصویر، ورودیها مقادیر پیکسلها هستند و در مدل زبانی، واژهها یا توکنها ابتدا به بردارهای عددی تبدیل میشوند.
- لایههای پنهان: لایههای میان ورودی و خروجی، پنهان نامیده میشوند. محاسبات اصلی در این بخش انجام میشود. هر لایه، خروجی لایه قبل را به بازنمایی تازهای تبدیل میکند. تعداد لایهها، تعداد نورونها و نوع اتصال آنها بخشی از معماری شبکه است.
- لایه خروجی: لایه خروجی پاسخ نهایی را تولید میکند. ساختار آن به نوع مسئله بستگی دارد. در رگرسیون ممکن است یک عدد مانند قیمت خانه تولید شود. در طبقهبندی دودویی احتمال تعلق نمونه به یک کلاس محاسبه میشود. در طبقهبندی چندکلاسه برای هر کلاس یک امتیاز یا احتمال به دست میآید. در مدلهای مولد، خروجی میتواند توکن بعدی متن، بخشی از تصویر یا یک سیگنال صوتی باشد.
- وزنها و بایاسها: وزنها و بایاسها پارامترهای قابل یادگیری شبکه هستند. در شروع آموزش معمولاً مقداردهی اولیه میشوند و سپس الگوریتم آموزش آنها را تغییر میدهد. هدف این است که ترکیب پارامترها، خطای مدل روی دادههای جدید را تا حد امکان کاهش دهد.
- تابع فعالسازی: اگر میان لایهها فقط تبدیل خطی انجام شود، رویهمگذاشتن چند لایه همچنان معادل یک تبدیل خطی خواهد بود. تابع فعالسازی، خاصیت غیرخطی را وارد شبکه میکند و امکان یادگیری روابط پیچیده را میدهد.
| تابع | کاربرد رایج | توضیح ساده |
|---|---|---|
| ReLU | بیشتر لایههای پنهان | مقادیر منفی را صفر میکند و آموزش شبکههای عمیق را سادهتر میسازد |
| Leaky ReLU | لایههای پنهان | برای مقادیر منفی شیب کوچکی نگه میدارد و خطر نورونهای مرده را کم میکند |
| Sigmoid | خروحی طبقهبندی دودویی | مقدار را به بازه صفر تا یک تبدیل میکند |
| Tanh | برخی شبکههای ترتیبی | خروجی را در بازه منفی یک تا مثبت یک قرار میدهد |
| Softmax | خروجی طبقهبندی چندکلاسه | امتیاز کلاسها را به توزیعی با مجموع یک تبدیل میکند |
- تابع زیان یا خطا: تابع زیان فاصله میان پیشبینی مدل و پاسخ درست را اندازه میگیرد. برای نمونه، در طبقهبندی از Cross-Entropy و در برخی مسائل رگرسیون از Mean Squared Error استفاده میشود. آموزش شبکه در واقع تلاش برای کمینهکردن این مقدار است.
- بهینهساز و نرخ یادگیری: بهینهساز مشخص میکند پارامترها چگونه تغییر کنند. Gradient Descent، SGD و Adam از روشهای شناختهشدهاند. نرخ یادگیری نیز اندازه هر تغییر را تعیین میکند. نرخ بسیار بزرگ ممکن است آموزش را ناپایدار کند و نرخ بسیار کوچک، یادگیری را بیش از حد کند سازد.
شبکه عصبی چگونه کار میکند و یاد میگیرد؟
شبکه عصبی در ابتدای کار چیزی درباره مسئلهای که قرار است حل کند نمیداند. مدل با دیدن دادهها، مقایسه پیشبینیهای خود با پاسخ درست و اصلاح خطاها، بهتدریج الگوهای موجود در داده را یاد میگیرد. آموزش شبکه عصبی را میتوان در شش مرحله ساده خلاصه کرد:
مرحله اول: آمادهسازی داده
قبل از شروع آموزش، دادهها جمعآوری، پاکسازی و به قالب عددی قابلفهم برای مدل تبدیل میشوند. معمولاً داده را به سه بخش تقسیم میکنند:
- داده آموزش: برای یادگیری پارامترها
- داده اعتبارسنجی: برای انتخاب معماری و تنظیم ابرپارامترها
- داده آزمون: برای ارزیابی نهایی روی نمونههایی که مدل در آموزش ندیده است
جداسازی درست این بخشها اهمیت زیادی دارد. چون از نشت اطلاعات و ارزیابی بیش از حد خوشبینانه عملکرد مدل جلوگیری میکند.
مرحله دوم: انتشار رو به جلو
در این مرحله، داده وارد لایه اول میشود، از لایههای پنهان عبور میکند و در نهایت به لایه خروجی میرسد. این حرکت Forward Pass نام دارد. شبکه با استفاده از وزنهای فعلی خود، یک پیشبینی تولید میکند.
برای مثال، در تشخیص ایمیل ناخواسته، ویژگیهایی مانند واژهها، فرستنده و ساختار پیام وارد مدل میشوند و خروجی میتواند احتمال اسپمبودن ایمیل باشد.
مرحله سوم: محاسبه خطا
حالا باید مشخص شود پیشبینی شبکه تا چه اندازه درست بوده است. برای این کار، پیشبینی مدل با برچسب واقعی مقایسه میشود. اگر ایمیل واقعاً اسپم باشد اما مدل احتمال کمی برای اسپمبودن آن در نظر بگیرد، مقدار زیان بالا خواهد بود.
مرحله چهارم: پسانتشار خطا
بعد از مشخص شدن میزان خطا، شبکه باید بفهمد کدام بخشها در ایجاد آن نقش داشتهاند. در Backpropagation، مدل از خروجی به سمت لایههای قبل حرکت میکند و با استفاده از قاعده زنجیرهای محاسبه میکند هر وزن چه سهمی در خطای نهایی داشته است. نتیجه این محاسبه، گرادیان پارامترهاست.
مرحله پنجم: بهروزرسانی وزنها
در این مرحله، بهینهساز وزنها و بایاسها را در جهتی تغییر میدهد که انتظار میرود خطای مدل کمتر شود. اندازه این تغییر تحت تأثیر نرخ یادگیری است.
مرحله ششم: تکرار و ارزیابی
یادگیری شبکه عصبی با یک بار انجام این مراحل تمام نمیشود. این چرخه بارها روی دستههای مختلف داده تکرار میشود تا مدل به عملکرد مناسبی برسد. سپس نتیجه روی داده اعتبارسنجی و در پایان روی مجموعه آزمون بررسی میشود.
تفاوت Epoch، Batch و Iteration
هنگام آموزش شبکههای عصبی، سه اصطلاح Epoch، Batch و Iteration زیاد تکرار میشوند. تفاوت آنها به نحوه پردازش دادههای آموزشی مربوط است:
- Batch: بخشی از داده آموزشی که در یک مرحله پردازش میشود.
- Iteration: یک بار انتشار رو به جلو، محاسبه خطا، پسانتشار و بهروزرسانی پارامترها برای یک Batch.
- Epoch: یک بار عبور کامل مدل از تمام دادههای آموزشی.
اگر ۱۰ هزار نمونه و اندازه Batch برابر ۱۰۰ باشد، هر Epoch شامل ۱۰۰ Iteration است.
انواع یادگیری در شبکههای عصبی
همه شبکههای عصبی به یک شکل آموزش نمیبینند. بسته به اینکه چه دادهای در اختیار داریم و از مدل چه انتظاری داریم، روش یادگیری میتواند متفاوت باشد. معماری شبکه و روش یادگیری نیز دو مفهوم جدا از هم هستند و یک معماری ممکن است با روشهای مختلف آموزش ببیند.
یادگیری نظارتشده
در یادگیری نظارتشده، مدل با جفت «ورودی و پاسخ درست» آموزش میبیند. یعنی هنگام آموزش، علاوه بر داده ورودی، پاسخ مورد انتظار نیز مشخص است. تشخیص گربه و سگ، پیشبینی قیمت و شناسایی ایمیل اسپم نمونههایی از این روش هستند. طبقهبندی و رگرسیون رایجترین وظایف نظارتشدهاند.
یادگیری بدون نظارت و خودنظارتی
در یادگیری بدون نظارت، برچسب آماده در اختیار مدل نیست و هدف میتواند کشف ساختار، کاهش بُعد یا گروهبندی دادهها باشد. خودرمزگذارها نمونهای از شبکههایی هستند که میتوانند بازنمایی فشرده یاد بگیرند.
در یادگیری خودنظارتی نیز خود داده، سیگنال آموزشی تولید میکند؛ برای مثال مدل زبانی با پیشبینی بخش حذفشده یا توکن بعدی آموزش میبیند. خوشهبندی یکی از کاربردهای یادگیری بدون نظارت است، اما هر شبکه عصبی بهطور خودکار الگوریتم خوشهبندی نیست؛ باید هدف و تابع زیان مناسب برای این کار تعریف شود.
یادگیری تقویتی
در یادگیری تقویتی، یک عامل با محیط تعامل میکند، عمل انجام میدهد و در مقابل پاداش یا جریمه میگیرد. شبکه عصبی میتواند سیاست تصمیمگیری یا ارزش وضعیتها را تقریب بزند. بازیها، کنترل ربات و برخی سامانههای تصمیمگیری از کاربردهای این رویکرد هستند.
شبکه عصبی عمیق یا DNN چیست؟
شبکه عصبی عمیق یا Deep Neural Network شبکهای است که چندین لایه محاسباتی دارد و میتواند داده را در چند سطح مختلف پردازش کند. در این شبکهها، هر لایه میتواند ویژگیهای متفاوتی را از داده یاد بگیرد و نتیجه را برای پردازش بیشتر به لایه بعدی منتقل کند. واژه عمیق در اینجا به عمق معماری اشاره میکند، نه به میزان هوشمندی مدل.
برای تعداد لایههایی که یک شبکه را عمیق میکند، مرز عددی کاملاً جهانشمولی وجود ندارد. در منابع مقدماتی معمولاً شبکه دارای چند لایه پنهان را عمیق مینامند، اما در عمل معماریهای مدرن میتوانند دهها، صدها یا تعداد بسیار بیشتری لایه و بلوک محاسباتی داشته باشند. مهمتر از شمارش ظاهری لایهها، زنجیره تبدیلهایی است که داده طی میکند.
شبکه عمیق معمولاً ظرفیت بیشتری دارد، اما عمق بیشتر همیشه بهتر نیست. معماری بزرگتر میتواند به داده، حافظه و زمان آموزش بیشتری نیاز داشته باشد و خطر بیشبرازش را افزایش دهد.
انواع شبکههای عصبی در یادگیری عمیق
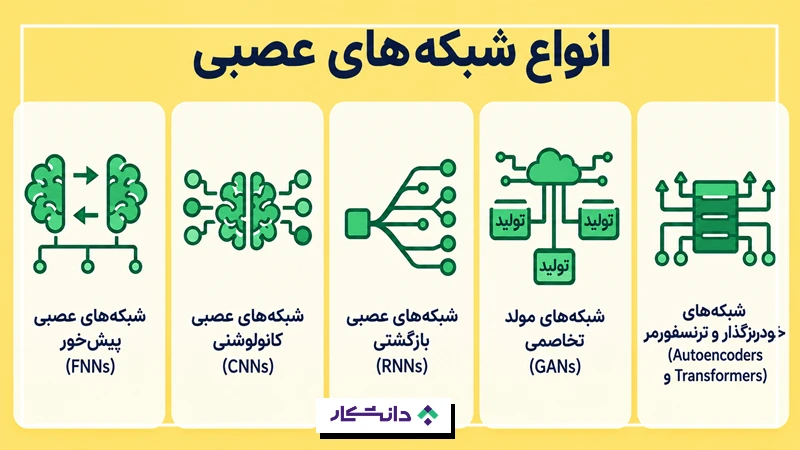
شبکههای عصبی فقط یک معماری مشخص ندارند. بسته به نوع داده و مسئلهای که قرار است حل شود، ساختارهای مختلفی برای آنها طراحی شده است. شبکههای عصبی را میتوان بر اساس جریان داده، نوع اتصال و مسئله هدف دستهبندی کرد. ANN یک اصطلاح چتری برای شبکه عصبی مصنوعی است؛ هرچند در بعضی مطالب، ANN بهصورت غیررسمی برای شبکه کاملاً متصل یا MLP به کار میرود.
۱. پرسپترون
پرسپترون یکی از سادهترین مدلهای شبکه عصبی و مناسب درک مفهوم وزن، بایاس و مرز تصمیم است. پرسپترون تکلایه فقط مسائل خطیِ قابل جداسازی را حل میکند؛ بنابراین برای الگوهای پیچیده کافی نیست، اما نقطه شروع آموزشی بسیار خوبی است.
۲. شبکه پیشخور و پرسپترون چندلایه؛ FNN و MLP
در شبکه پیشخور، اطلاعات از ورودی به خروجی حرکت میکند و در مسیر استنتاج حلقه بازگشتی وجود ندارد. پرسپترون چندلایه یا MLP معمولاً از لایههای کاملاً متصل تشکیل شده و برای دادههای جدولی، طبقهبندی و رگرسیون مناسب است.
MLP میتواند روابط غیرخطی را یاد بگیرد، اما برای تصویر بزرگ تعداد پارامترهای زیادی میسازد و ساختار مکانی پیکسلها را بهخوبی معماری CNN حفظ نمیکند.
۳. شبکه تابع پایه شعاعی؛ RBF
در شبکه RBF، نورونهای لایه پنهان از تابع پایه شعاعی استفاده میکنند و شباهت نمونه را نسبت به مراکز یادگرفتهشده میسنجند. این شبکهها در تقریب تابع، تشخیص الگو و برخی مسائل پیشبینی به کار میروند. انتخاب تعداد و موقعیت مراکز، پهنای توابع و کنترل بیشبرازش از چالشهای آنهاست.
۴. شبکه عصبی کانولوشنی؛ CNN
CNN برای دادههایی با ساختار مکانی یا شبکهای، بهویژه تصویر، طراحی شده است. فیلترها یا کرنلها روی بخشهای مختلف ورودی حرکت میکنند و ویژگیهایی مانند لبه، بافت و شکل را استخراج میکنند. اشتراک وزن باعث میشود تعداد پارامترها نسبت به یک شبکه کاملاً متصل کمتر باشد.
یک CNN معمولاً از لایههای کانولوشن، تابع فعالسازی، Pooling یا روشهای کاهش ابعاد و در پایان لایههای پیشبینی تشکیل میشود. طبقهبندی تصویر، تشخیص اشیا، بخشبندی تصویر، تحلیل تصاویر پزشکی و کنترل کیفیت بصری از کاربردهای آن هستند. معماریهایی مانند LeNet، AlexNet، VGG، ResNet و MobileNet نمونههای شناختهشده این خانوادهاند.
۵. شبکه عصبی بازگشتی؛ RNN، LSTM و GRU
RNN برای دادههای ترتیبی طراحی شده و حالت قبلی را در محاسبه مرحله فعلی دخالت میدهد. به همین دلیل برای سری زمانی، متن و صوت قابل استفاده است. RNN ساده در یادگیری وابستگیهای طولانی ممکن است با محوشدن یا انفجار گرادیان روبهرو شود.
LSTM و GRU با سازوکارهای دروازهای، نگهداری و فراموشکردن اطلاعات را بهتر مدیریت میکنند. این مدلها همچنان در برخی مسائل سری زمانی، سامانههای کوچک و پردازش جریان داده مفیدند؛ هرچند ترنسفورمرها در بسیاری از وظایف زبانی جایگزین RNN شدهاند.
۶. خودرمزگذار و معماری رمزگذار ـ رمزگشا
خودرمزگذار یا Autoencoder ورودی را به یک نمایش فشرده تبدیل میکند و سپس میکوشد آن را بازسازی کند. کاهش بُعد، حذف نویز، تشخیص ناهنجاری و یادگیری بازنمایی از کاربردهای آن است.
در معماری Encoder–Decoder، رمزگذار ورودی را به نمایش میانی تبدیل میکند و رمزگشا خروجی موردنظر را میسازد. این الگو محدود به RNN نیست و میتواند با CNN یا ترنسفورمر پیادهسازی شود. ترجمه ماشینی، خلاصهسازی، بخشبندی تصویر و تولید داده از کاربردهای آن هستند.
۷. شبکه مولد تخاصمی؛ GAN
GAN از دو شبکه تشکیل میشود؛ مولد تلاش میکند نمونههای واقعینما بسازد و تمایزدهنده میکوشد داده واقعی را از داده ساختگی تشخیص دهد. رقابت این دو میتواند به تولید تصویر و تبدیل سبک منجر شود. آموزش ناپایدار و تنوع پایین خروجیها از چالشهای کلاسیک GAN است. امروزه مدلهای انتشار نیز در بسیاری از کاربردهای تولید تصویر اهمیت زیادی دارند.
۸. ترنسفورمر
ترنسفورمر معماریای مبتنی بر سازوکار توجه است. توجه به مدل اجازه میدهد هنگام پردازش هر بخش از ورودی، ارتباط آن را با بخشهای دیگر بسنجد. برخلاف RNN، بسیاری از محاسبات توالی در ترنسفورمر قابل موازیسازی است.
مدلهای زبانی بزرگ، چتباتها، ترجمه، خلاصهسازی و تولید کد بر این خانواده تکیه دارند. ترنسفورمرها فقط برای متن نیستند؛ Vision Transformer برای تصویر و مدلهای چندوجهی برای ترکیب متن، تصویر و صوت نیز از همین ایده استفاده میکنند. با این حال هزینه حافظه و محاسبات میتواند بالا باشد و ترنسفورمر همیشه بهترین انتخاب برای هر پروژه نیست.
۹. شبکه عصبی گراف؛ GNN
GNN برای دادههایی ساخته شده که رابطه میان موجودیتها اهمیت دارد؛ مانند شبکه اجتماعی، مولکول، مسیرهای حملونقل یا گراف تراکنشهای مالی. هر گره اطلاعات همسایههای خود را تجمیع میکند تا بازنمایی بهتری بسازد. پیشنهاد ارتباط، کشف تقلب و پیشبینی خواص مولکولی از کاربردهای آن است.
۱۰. شبکههای ماژولار و مدلهای چندکارشناس
در شبکه ماژولار، مسئله میان چند زیرشبکه تقسیم میشود و خروجی آنها ترکیب میگردد. این ایده در سامانههای چندوظیفهای و معماریهای Mixture of Experts نیز دیده میشود؛ جایی که فقط تعدادی از کارشناسان برای هر ورودی فعال میشوند. مزیت آن تخصصیشدن بخشهاست، اما مسیریابی، توازن بار و آموزش هماهنگ شبکهها پیچیدگی ایجاد میکند.
مقایسه ANN، CNN، RNN و Transformer
انتخاب نوع شبکه عصبی تا حد زیادی به نوع داده و مسئلهای که میخواهیم حل کنیم بستگی دارد. برای مثال، معماری مناسب پردازش تصویر لزوماً بهترین انتخاب برای متن یا دادههای سری زمانی نیست. هر معماری با توجه به نوع اتصال نورونها، داده ورودی و مسئله هدف، نقاط قوت و محدودیتهای متفاوتی دارد. جدول زیر این تفاوتها را بهصورت خلاصه نشان میدهد.
| معماری | داده مناسب | نقطه قوت اصلی | محدودیت رایج | نمونه کاربرد |
|---|---|---|---|---|
| MLP / ANN کامل متصل | داده جدولی و بردار ویژگی | ساده، انعطافپذیر و مناسب خط پایه | پارامتر زیاد برای تصویر و بیتوجهی به ساختار مکانی | امتیازدهی، پیشبینی ریزش مشتری |
| CNN | تصویر، ویدیو و الگوهای محلی | استخراج ویژگی مکانی و اشتراک وزن | نیاز به داده و محاسبه؛ درک روابط بسیار دور ممکن است دشوار باشد | تشخیص شیء و تصویر پزشکی |
| RNN / LSTM / GRU | توالی و سری زمانی | حفظ حالت و مدلسازی ترتیب | آموزش ترتیبی و مشکل وابستگیهای خیلی بلند | پیشبینی سری زمانی و گفتار |
| Transformer | متن، توالی، تصویر و داده چندوجهی | توجه به وابستگیهای دور و موازیسازی | مصرف حافظه و محسابات بالا | مدل زبانی، ترجمه و تولید محتوا |
| GNN | گراف و داده رابطهای | استفاده مستقیم از ارتباط میان گرهها | ساخت گراف و مقیاسپذیری | کشف تقلب و تحلیل مولکول |
چگونه معماری مناسب را انتخاب کنیم؟
برای انتخاب معماری شبکه عصبی، بهتر است ابتدا به نوع داده و مسئله نگاه کنیم. البته این تنها معیار تصمیمگیری نیست و در ادامه باید عواملی مانند حجم داده، منابع سختافزاری و دقت موردنیاز را نیز در نظر گرفت.
- برای داده جدولی کوچک یا متوسط، ابتدا مدلهای کلاسیک و سپس MLP را بهعنوان خط پایه آزمایش کنید.
- برای تصویر و ویدئو، CNN انتخاب رایجی است؛ در پروژههای بزرگ میتوان Vision Transformer را نیز مقایسه کرد.
- برای متن و وابستگیهای طولانی، ترنسفورمر معمولاً گزینه اصلی است.
- برای سری زمانی، هیچ برنده همیشگی وجود ندارد؛ مدلهای آماری، درختی، MLP، CNN یکبعدی، LSTM و ترنسفورمر باید بر اساس داده مقایسه شوند.
- برای داده رابطهای، GNN مناسب است.
- برای تولید تصویر، مدلهای انتشار و در بعضی کاربردها GAN بررسی میشوند.
نوع داده فقط یکی از معیارهاست. اندازه دیتاست، سرعت پاسخ، حافظه، هزینه استقرار، تفسیرپذیری و دقت موردنیاز نیز باید در تصمیم لحاظ شوند.
کاربردهای شبکه عصبی در دنیای واقعی
شبکههای عصبی فقط مفاهیمی تئوری نیستند و بسیاری از سرویسهایی که روزانه از آنها استفاده میکنیم به این فناوری وابستهاند. توانایی این مدلها در تشخیص الگو، یادگیری ویژگی و پردازش دادههای پیچیده باعث شده است در حوزههای مختلفی از تصویر و زبان گرفته تا پزشکی و صنعت استفاده شوند.
پردازش تصویر و تشخیص چهره
شبکههای عصبی میتوانند تصویر را طبقهبندی کنند، اشیا را پیدا کنند، مرز هر شیء را مشخص کنند یا کیفیت تصویر را بهبود دهند. تشخیص چهره، خواندن پلاک، کنترل کیفیت محصول و تحلیل تصاویر ماهوارهای نمونههایی از این حوزهاند.
پردازش زبان طبیعی و چتباتها
ترجمه ماشینی، خلاصهسازی، تحلیل احساسات، جستوجوی معنایی، پاسخگویی به سؤال و تولید متن با شبکههای عصبی انجام میشوند. مدلهای زبانی بزرگ مانند خانواده GPT بر معماری ترنسفورمر استوارند و با پیشبینی توکنها، الگوهای زبان را یاد میگیرند.
تشخیص گفتار و پردازش صوت
تبدیل گفتار به متن، شناسایی گوینده، حذف نویز، ساخت صدای مصنوعی و تحلیل موسیقی از کاربردهای شبکه عصبی در صوت هستند. بسته به مسئله میتوان از CNN، RNN یا ترنسفورمر استفاده کرد.
سیستمهای پیشنهاددهنده
فروشگاهها و پلتفرمهای محتوا با تحلیل رفتار کاربر، محصول، فیلم، موسیقی یا مطلب مرتبط پیشنهاد میکنند. شبکه عصبی میتواند بازنمایی کاربر و کالا را یاد بگیرد و رابطههای پنهان میان آنها را پیدا کند.
پزشکی و سلامت
تحلیل رادیولوژی و MRI، کمک به تشخیص بیماری، پیشبینی ریسک و کشف مولکولهای دارویی از کاربردهای مهم هستند. در این حوزه، ارزیابی بالینی، کیفیت داده، توضیحپذیری و نظارت متخصص ضروری است؛ خروجی مدل جایگزین خودکار قضاوت پزشک نیست.
بانکداری، بیمه و کشف تقلب
مدل میتواند الگوهای غیرعادی در تراکنشها را شناسایی کند، ریسک را تخمین بزند یا اسناد را پردازش کند. چون خطا در این حوزه هزینهبر است، معیارهایی مانند Precision و Recall، کنترل سوگیری و امکان بررسی انسانی اهمیت زیادی دارند.
خودروهای خودران و رباتیک
تشخیص عابر و تابلو، درک مسیر، ترکیب اطلاعات حسگرها و کنترل حرکت به مدلهای یادگیری عمیق متکیاند. چنین سامانههایی معمولاً چند شبکه و الگوریتم مکمل را همراه با قواعد ایمنی به کار میگیرند.
صنعت، کشاورزی و نگهداری پیشبینانه
شبکه عصبی با تحلیل تصویر، صوت دستگاه و داده حسگر میتواند عیب محصول، خرابی احتمالی تجهیزات یا بیماری گیاه را شناسایی کند. هدف، کاهش توقف تولید، مصرف منابع و هزینه بازرسی است.
هوش مصنوعی مولد
تولید متن، تصویر، صوت، ویدئو و کد از شناختهشدهترین کاربردهای جدید هوش مصنوعی مولد است. ترنسفورمر، خودرمزگذار، GAN و مدل انتشار هرکدام در بخشی از سامانههای مولد نقش دارند.
مزایای شبکههای عصبی
دلیل استفاده گسترده از شبکههای عصبی فقط قدرت محاسباتی آنها نیست. این مدلها میتوانند بسیاری از الگوها و ویژگیهای مهم را مستقیماً از داده یاد بگیرند و برای مسائل مختلف سازگار شوند. مهمترین مزایای استفاده از شبکههای عصبی عبارتاند از:
- یادگیری روابط غیرخطی: شبکه میتواند الگوهای پیچیده میان ورودی و خروجی را مدل کند.
- استخراج خودکار ویژگی: نیاز به تعریف دستی همه ویژگیها کاهش مییابد.
- کار با داده بدون ساختار: تصویر، متن، صوت و ویدئو مستقیماً قابل پردازشاند.
- یادگیری انتقالی: میتوان یک مدل ازپیشآموزشدیده را با داده کمتر برای مسئله جدید سازگار کرد.
- مقیاسپذیری: مدلها با داده و محاسبات بیشتر میتوانند ظرفیت بالاتری پیدا کنند.
- انعطاف معماری: برای داده مکانی، ترتیبی، گرافی یا چندوجهی معماریهای تخصصی وجود دارد.
- امکان یادگیری سرتاسری: اجزای سامانه میتوانند بهطور مشترک برای هدف نهایی بهینه شوند.
محدودیتها و چالشهای شبکه عصبی
با وجود تواناییهای زیاد، شبکه عصبی همیشه بهترین انتخاب برای حل یک مسئله نیست. استفاده از این مدلها میتواند به داده و منابع محاسباتی زیادی نیاز داشته باشد و چالشهایی مانند تفسیرپذیری و بیشبرازش نیز مطرح هستند. بنابراین پیش از انتخاب شبکه عصبی باید محدودیتهای آن را هم شناخت.
نیاز به داده مناسب
داده بیشتر همیشه به معنای نتیجه بهتر نیست؛ کیفیت، تنوع، پوشش حالات واقعی و صحت برچسبها تعیینکنندهاند. یک مدل آموزشدیده با داده سوگیرانه میتواند همان سوگیری را بازتولید کند.
هزینه محاسبات و انرژی
مدلهای بزرگ به سختافزار، حافظه و زمان قابلتوجه نیاز دارند. هزینه آموزش فقط بخشی از مسئله است؛ سرعت و هزینه استنتاج در محیط واقعی نیز باید سنجیده شود.
تفسیرپذیری محدود
فهم دقیق دلیل یک پیشبینی در شبکه عمیق دشوار است. در حوزههای حساس باید از روشهای توضیحپذیری، ثبت فرایند، ارزیابی متخصص و کنترل انسانی استفاده کرد.
بیشبرازش
مدل ممکن است جزئیات و نویز داده آموزش را حفظ کند و روی داده جدید ضعیف باشد. فاصله زیاد میان عملکرد آموزش و اعتبارسنجی نشانه رایج بیشبرازش است.
محوشدن و انفجار گرادیان
در شبکههای عمیق، گرادیان ممکن است بسیار کوچک یا بسیار بزرگ شود. نتیجه، یادگیری کند یا ناپایدار است. مقداردهی اولیه مناسب، توابعی مانند ReLU، نرمالسازی، اتصال باقیمانده، Gradient Clipping و در شبکههای ترتیبی LSTM یا GRU میتوانند کمک کنند.
امنیت، حریم خصوصی و تغییر داده
مدل ممکن است در برابر ورودی خصمانه، نشت اطلاعات یا سوءاستفاده آسیبپذیر باشد. همچنین الگوی داده در طول زمان تغییر میکند؛ پدیدهای که Data Drift نام دارد. پایش مداوم، آزمون امنیتی و آموزش مجدد برای سامانه عملی ضروری است.
مشکلات رایج آموزش و راهحلهای متداول
حتی با انتخاب معماری مناسب، ممکن است شبکه عصبی هنگام آموزش با مشکلات مختلفی روبهرو شود. بیشبرازش، نرخ یادگیری نامناسب یا گرادیان ناپایدار از جمله مواردی هستند که میتوانند کیفیت یا سرعت یادگیری مدل را کاهش دهند. در جدول زیر، نشانههای رایج هر مشکل و راهحلهای متداول آنها را مشاهده میکنید.
| مشکل | نشانه | راهحلهای متداول |
|---|---|---|
| بیشبرازش | خطای آموزش کم و خطای اعتبارسنجی زیاد | داده بیشتر، افزایش داده، Dropout، منظمسازی L1/L2، Early Stopping |
| کمبرازش | عملکرد ضعیف روی آموزش و آزمون | مدل مناسبتر، ویژگی یا داده بهتر، آموزش بیشتر، تنظیم نرخ یادگیری |
| محوشدن گرادیان | یادگیری بسیار کند لایههای ابتدایی | ReLU و گونههای آن، مقداردهی اولیه مناسب، Batch Normalization، اتصال باقیمانده |
| انفجار گرادیان | نوسان شدید خطا یا NaN | Gradient Clipping، کاهش نرخ یادگیری، نرمالسازی |
| عدم توازن کلاسها | دقت ظاهری بالا ولی کشف ضعیف کلاسهای خاص | وزن کلاس، نمونهبرداری، معیارهای Precision، Recall و F1 |
| آموزش کند | زمان یا حافظه بیش از بودجه | انتقال یادگیری، مدل کوچکتر، Batch مناسب، Mixed Precision و شتابدهنده |
چه زمانی از شبکه عصبی استفاده کنیم؟
هر مسئلهای به شبکه عصبی نیاز ندارد. گاهی یک الگوریتم سادهتر با هزینه کمتر همان نتیجه موردنیاز را ارائه میدهد. شبکه عصبی بیشتر زمانی ارزش استفاده دارد که داده یا روابط میان آنها پیچیده باشند و مدلهای سادهتر نتوانند عملکرد مورد انتظار را ارائه دهند. شبکه عصبی زمانی گزینه مناسبی است که:
- داده کافی و باکیفیت دارید؛
- رابطه میان ورودی و خروجی پیچیده و غیرخطی است؛
- با تصویر، متن، صوت، ویدئو یا داده گرافی سروکار دارید؛
- دقت بالقوه بیشتر، هزینه محاسبات را توجیه میکند؛
- مدل ازپیشآموزشدیده مناسبی برای انتقال یادگیری وجود دارد.
اما اگر دیتاست کوچک و جدولی است، محدودیت سختافزاری جدی دارید، باید تصمیم مدل بهسادگی توضیح داده شود یا یک الگوریتم ساده به دقت کافی میرسد، بهتر است ابتدا از روشهای کلاسیک شروع کنید. اصل حرفهای این است: سادهترین مدلی را انتخاب کنید که نیاز واقعی پروژه را برآورده میکند.
مثال ساده از ساخت شبکه عصبی
برای اینکه مراحل ساخت و آموزش شبکه عصبی ملموستر شود، یک مسئله ساده طبقهبندی را در نظر بگیریم. فرض کنید هدف، تشخیص تصاویر لباس در ده گروه است. روند کلی چنین خواهد بود:
- تصاویر و برچسبها جمعآوری میشوند.
- مقادیر پیکسل به بازهای استاندارد تبدیل میشوند.
- داده به آموزش، اعتبارسنجی و آزمون تقسیم میشود.
- یک مدل ساده با لایه ورودی، چند لایه پنهان و ده خروجی ساخته میشود.
- تابع زیان طبقهبندی و بهینهساز انتخاب میشوند.
- مدل در چند Epoch آموزش میبیند.
- عملکرد روی داده دیدهنشده ارزیابی میشود.
- در صورت بیشبرازش، معماری یا روش منظمسازی اصلاح میشود
نمونه کد کوتاه با Keras را در بخش زیر میبینید:
import tensorflow as tf

model = tf.keras.Sequential([
    tf.keras.layers.Flatten(input_shape=(28, 28)),
    tf.keras.layers.Dense(128, activation="relu"),
    tf.keras.layers.Dropout(0.2),
    tf.keras.layers.Dense(10, activation="softmax")
])

model.compile(
    optimizer="adam",
    loss="sparse_categorical_crossentropy",
    metrics=["accuracy"]
)

model.fit(x_train, y_train, epochs=10, validation_split=0.1)
model.evaluate(x_test, y_test)
این کد یک MLP آموزشی است. برای تصاویر پیچیدهتر معمولاً CNN یا یک مدل ازپیشآموزشدیده انتخاب بهتری خواهد بود. همچنین دقت بهتنهایی همیشه کافی نیست و معیار ارزیابی باید با مسئله هماهنگ باشد.
ابزارهای ساخت و آموزش شبکه عصبی
برای ساخت شبکه عصبی لازم نیست محاسبات مربوط به نورونها، پسانتشار و بهروزرسانی وزنها را هر بار از ابتدا برنامهنویسی کنید. فریمورکها و ابزارهای مختلف این فرایند را سادهتر کردهاند و امکانات لازم برای تعریف، آموزش، ارزیابی و اجرای مدل را در اختیار توسعهدهندگان قرار میدهند.
| ابزار | مناسب برای | ویژگی شاخص |
|---|---|---|
| Keras / TensorFlow | شروع سریع و استقرار | API سطح بالا، آموزش و ابزارهای تولیدی گسترده |
| PyTorch | آموزش، پژوهش و توسعه منعطف | تعریف شهودی مدل و اکوسیستم قوی |
| JAX | محسابات عددی و پژوهش پیشرفته | تبدیل و کامپایل توابع و شتابدهی مناسب |
| Google Colab / Kaggle | تمرین بدون نصب سنگین | نوتبوک آنلاین و دسترسی محدود به شتابدهنده |
| Teachable Machine و AutoML | نمونهسازی کمکد یا بدون کد | ساخت نمونه اولیه بدون پیادهسازی کامل |
ابزارهای بدون کد برای درک فرایند و نمونه اولیه مفیدند، اما پروژه حرفهای معمولاً به برنامهنویسی، مدیریت داده، ارزیابی دقیق و استقرار نیاز دارد.
نقشه راه یادگیری شبکههای عصبی برای مبتدیان
اگر تازه وارد این حوزه شدهاید، لازم نیست تمام معماریها و مفاهیم شبکههای عصبی را همزمان یاد بگیرید. یادگیری مرحلهبهمرحله و انجام پروژه در کنار مفاهیم تئوری، مسیر سادهتر و کاربردیتری ایجاد میکند. مسیر زیر از مبانی پایتون و ریاضیات شروع میشود و پس از یادگیری مدلهای پایه، به معماریهای تخصصی و استقرار مدل میرسد.
- گام ۱؛ پایتون و کار با داده: مبانی Python، NumPy، Pandas و رسم نمودار را بیاموزید. لازم نیست پیش از شروع متخصص نرمافزار باشید، اما باید بتوانید داده را بارگذاری، پاکسازی و بررسی کنید.
- گام ۲؛ ریاضیات ضروری: مفاهیم پایه جبر خطی، بردار و ماتریس، مشتق، احتمال و آمار را همزمان با تمرین یاد بگیرید. برای شروع عملی، درک شهودی مهمتر از حفظ اثباتهای پیچیده است.
- گام ۳؛ مبانی یادگیری ماشین: تقسیم داده، تعمیمپذیری، بیشبرازش، تابع زیان، معیار ارزیابی و تفاوت طبقهبندی و رگرسیون را بشناسید. چند مدل ساده مانند رگرسیون و درخت تصمیم را نیز تجربه کنید تا بتوانید خط پایه بسازید.
- گام ۴؛ پرسپترون و MLP: یک نورون را از صفر پیادهسازی کنید و سپس با Keras یا PyTorch یک MLP بسازید. انتشار رو به جلو، گرادیان نزولی و پسانتشار را بهصورت مفهومی درک کنید.
- گام ۵؛ پروژههای کوچک: تشخیص ارقام MNIST، دستهبندی Fashion-MNIST یا پیشبینی روی داده جدولی پروژههای خوبی هستند. نمودار زیان آموزش و اعتبارسنجی را بررسی کنید و عمداً بیشبرازش را ایجاد و سپس کنترل کنید.
- گام ۶؛ معماری تخصصی: بر اساس علاقه، CNN برای تصویر، ترنسفورمر برای زبان، مدلهای سری زمانی یا GNN برای گراف را دنبال کنید. به جای حفظ نام معماریها، دلیل طراحی هر لایه را بفهمید.
- گام ۷؛ استقرار و MLOps: مدل فقط زمانی ارزش عملی دارد که نسخهبندی، پایش، امنیت، سرعت پاسخ و بهروزرسانی آن مدیریت شود. پس از مبانی، با API، کانتینر، ثبت آزمایشها و پایش Data Drift آشنا شوید.
منابع: ibm.com، developers.google.com